Cómo diseñé un sistema para que agentes de IA atiendan llamadas telefónicas
Roman Meclazcke
Backend & IA Engineer
Un recorrido técnico por una arquitectura de voz para agentes: telefonía, STT, agente, TTS, guardrails, trazabilidad y recolección de datos sin acoplarse a un proveedor.
Hablar con un agente de IA por teléfono parece una extensión natural de un chatbot: una persona hace una pregunta, el sistema responde y la conversación continúa. Pero detrás de esa experiencia hay bastante más que un modelo convertido en voz. Hay telefonía, audio en tiempo real, transcripción, control de turnos, seguridad, estado de sesión, herramientas y una forma de reconstruir qué pasó cuando la llamada terminó.
En este artículo quiero contar cómo encaré el diseño de un sistema para que un agente atienda llamadas entrantes. No es una receta atada a una empresa ni a una credencial concreta: los proveedores que menciono son los usados en esta implementación, pero cada capa puede cambiar. Lo importante es entender las responsabilidades y las decisiones que hacen que la solución sea mantenible.
La idea central es separar dos cosas que a primera vista parecen una sola: atender la llamada y observarla. La primera debe tener la menor latencia posible. La segunda debe permitir saber qué transcribió el sistema, qué respondió el agente, qué herramientas ejecutó y qué datos quedaron confirmados, sin volver frágil el audio en tiempo real.
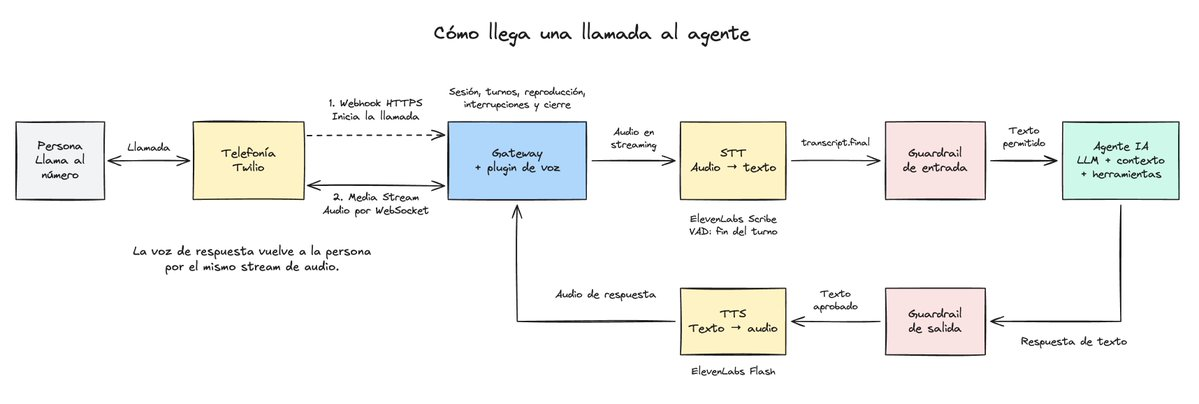
El recorrido de una llamada entrante: el carrier inicia la sesión por webhook, el Gateway administra el audio y el agente procesa cada turno antes de devolver la respuesta por el mismo stream.
El problema no es solamente convertir texto en voz
Una llamada no llega como texto. Llega desde la red telefónica y debe transformarse en una conversación que el agente pueda comprender y responder con naturalidad. Una arquitectura mínima necesita resolver, al menos, estas preguntas:
- ¿cómo entra la llamada desde el carrier telefónico?
- ¿cómo llega el audio al servidor y cómo vuelve la respuesta?
- ¿cuándo se considera que la persona terminó de hablar?
- ¿en qué momento se consulta al agente?
- ¿qué pasa si la persona interrumpe a la voz sintética?
- ¿cómo se filtra una entrada riesgosa antes de que llegue al modelo?
- ¿cómo se deja evidencia de lo ocurrido sin guardar promesas que el sistema no cumplió?
En mi implementación, la llamada entra por un proveedor de telefonía. Ese proveedor invoca un webhook HTTPS y abre un stream de audio bidireccional por WebSocket. Un Gateway recibe ese audio y se ocupa del estado técnico: admisión de la llamada, turnos, reproducción, interrupciones y cierre.
El proveedor concreto de telefonía puede cambiar. También puede cambiar el túnel o el mecanismo que expone el webhook. La decisión relevante es conservar el contrato: un punto público para iniciar la llamada y un canal de audio bidireccional que el motor de voz pueda administrar.
El flujo que está funcionando hoy: STT, agente y TTS
La primera versión usa un pipeline modular. El audio de la persona pasa por STT (speech-to-text), el agente razona sobre el transcript y produce una respuesta de texto, y un servicio de TTS (text-to-speech) la transforma nuevamente en audio.
En este caso, el reconocimiento y la síntesis se resuelven con servicios de voz separados. Hoy se usan ElevenLabs Scribe para STT y ElevenLabs Flash para TTS, mientras que Twilio actúa como carrier. Podrían reemplazarse por otros proveedores siempre que se mantengan las interfaces de audio, transcripción y síntesis.
El flujo, simplificado, es el siguiente:
- La persona llama al número.
- El carrier envía el webhook de inicio y abre el Media Stream.
- El Gateway recibe audio telefónico por WebSocket.
- El motor STT transcribe en streaming y detecta el final del turno mediante VAD (voice activity detection).
- Cuando existe un
transcript.final, los guardrails revisan la entrada. - El agente recibe el texto permitido, su contexto y las herramientas que le correspondan.
- La respuesta del modelo atraviesa los guardrails de salida.
- El TTS sintetiza el texto aprobado y el Gateway lo devuelve por el stream de audio.
La llamada no pasa por un navegador. Tampoco hace falta que una capa adicional toque el audio para registrar telemetría. El plugin de voz del Gateway es dueño del transporte, de la sesión técnica, del barge-in y del cierre.
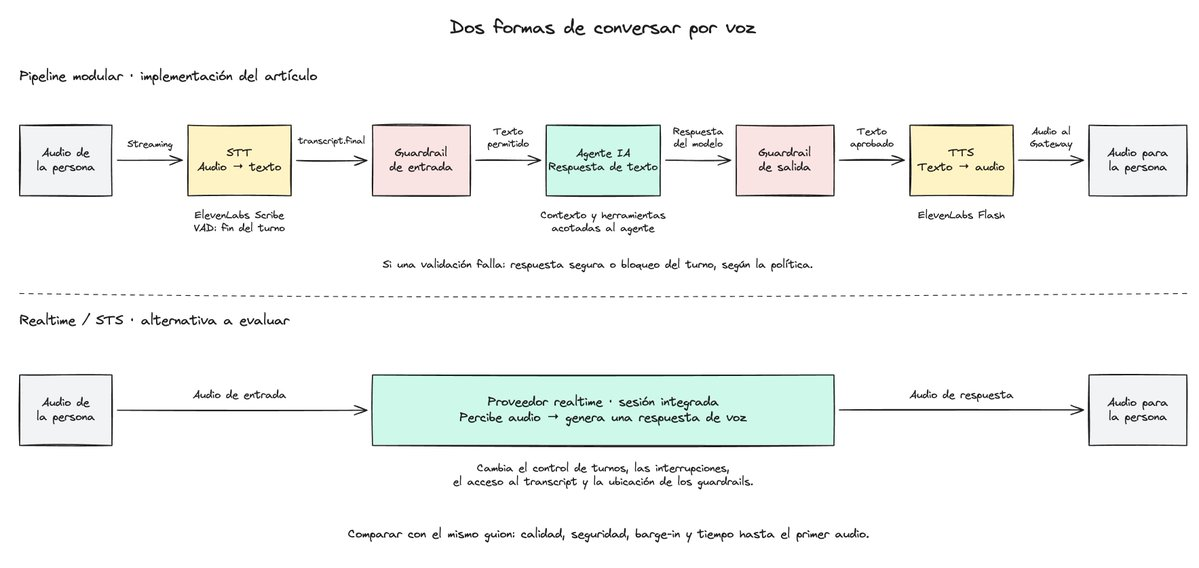
El pipeline modular separa STT, guardrails, agente y TTS. También se muestra la alternativa realtime, que reduce pasos pero cambia el control de turnos, interrupciones y validaciones.
¿Por qué empezar por un pipeline modular?
Porque vuelve visibles los puntos de control. El transcript final es una pieza concreta que se puede revisar antes de invocar al agente. La salida textual también se puede validar antes de pronunciarla. Además, STT, modelo y TTS se pueden evaluar o reemplazar por separado.
No significa que sea la única alternativa. Una arquitectura de voz en tiempo real puede trabajar de manera más directa, de audio a audio, lo que muchas veces se llama speech-to-speech o STS. En ese modo, un proveedor realtime integra percepción, conversación y generación de voz en una misma sesión.
Esto puede reducir la cantidad de saltos y hacer que la interacción se sienta más fluida. Pero no es un cambio cosmético: modifica el modelo de turnos, las interrupciones, la latencia, el acceso al texto transcripto y dónde colocar los guardrails. Por eso lo traté como una alternativa configurable, no como un reemplazo automático del pipeline modular. Antes de adoptarla conviene compararla contra un mismo guion de llamadas y medir calidad, seguridad, barge-in y tiempo hasta el primer audio.
Guardrails: una capa antes de escuchar y otra antes de hablar
En una llamada, una entrada insegura no deja de ser insegura por ser oral. La transcripción puede contener intentos de manipular al agente, pedidos fuera de alcance o información que no debería llegar a una herramienta. Del otro lado, una respuesta puede filtrar datos, prometer una acción inexistente o ser impropia para decirle a una persona por teléfono.
Por eso el flujo tiene guardrails en dos momentos:
- Entrada: después del transcript final y antes del agente.
- Salida: después de la respuesta del modelo y antes del TTS.
Esta ubicación es deliberada. El guardrail de entrada ve lo que el sistema entendió de la persona, y el de salida revisa exactamente el texto que se va a convertir en voz. Si una validación falla, la política debe definir una respuesta segura o el bloqueo del turno. No alcanza con asumir que el prompt del agente lo va a resolver.
Esta separación permite revisar la entrada antes de que llegue al agente y la respuesta antes de convertirse en voz. La conversación telefónica puede sentirse natural, pero sigue necesitando controles contra instrucciones maliciosas, pedidos fuera de alcance y respuestas que expongan datos o prometan acciones inexistentes. La voz suma inmediatez, pero no elimina los riesgos de un sistema agéntico.
Un agente de voz no debería heredar todas las herramientas internas
Otra decisión importante fue separar el agente de recepción del agente interno. El primero tiene un workspace propio, contexto acotado y herramientas explícitas. El segundo puede conservar capacidades que sirven para operar internamente, pero que no corresponde ofrecerle de forma predeterminada a alguien que llama.
Es una aplicación práctica del principio de menor privilegio: la llamada debe poder resolver su objetivo sin exponer herramientas o conocimiento que no necesita. Si en el futuro hace falta habilitar una acción externa, esa acción merece una tool específica, validaciones propias y una auditoría separada.
El sistema puede detectar, por ejemplo, que la persona pide hablar con un humano, que el caso está fuera de alcance o que faltan datos después de varios intentos de aclaración. La tool de detección registra ese hecho de manera idempotente, pero no transfiere la llamada, crea un ticket, promete un callback ni notifica a alguien. Detectar una necesidad y ejecutar una consecuencia son dos responsabilidades distintas.
Esa diferencia evita un problema común en los asistentes: que el modelo diga "ya lo derivé" cuando ninguna integración externa se ejecutó realmente.
El estado de una llamada no es solo una conversación
Una conversación de voz puede contener datos útiles, pero el texto libre no es suficiente para operar con confianza. Por eso agregué una tool específica para registrar campos estructurados durante la llamada.
Por ejemplo, el agente puede detectar un nombre, teléfono, motivo o franja horaria. Cuando la persona lo menciona, se registra como detected. Recién después de que confirme explícitamente ese valor exacto pasa a confirmed.
missing → detected → confirmed
             │
             └── detected (si la persona corrige el valor)
El detalle importa: el silencio, la falta de corrección, el resumen del agente o el fin de un flujo no son confirmación. Si alguien corrige su número de teléfono, se conserva el historial en lugar de pisar el dato anterior. Así se puede saber qué se escuchó, qué se confirmó y en qué turno ocurrió.
La tool no inserta datos en un CRM ni dispara una acción comercial. Su responsabilidad actual es validar y dejar evidencia estructurada. Cuando llegue el momento de conectar una integración, esa integración debe ser otra acción explícita y verificable.
También hay un plugin para el ciclo de vida de skills. El agente activa una skill cuando corresponde a la intención de la llamada y registra un resultado terminal cuando completa, cancela o falla. La evidencia no es una palabra que dijo el modelo: es la ejecución real de la tool. Esa distinción hace que una traza sea útil para auditar en lugar de ser solo un relato de lo que el modelo cree haber hecho.
Escalar a una persona sin romper la conversación
Hay situaciones en las que la mejor respuesta de un agente es dar lugar a una persona: cuando quien llama lo pide, cuando el caso está fuera de alcance, cuando falta información esencial después de aclarar el contexto o cuando una regla del negocio marca una prioridad particular.
El plugin de escalamiento transforma esa situación en un evento estructurado con motivo, prioridad y resumen. A partir de ahí, una capa de orquestación consume el evento y ejecuta una única acción de escalamiento por llamada. La idempotencia es importante: si el agente vuelve a detectar el mismo caso o si el proceso se reintenta, no debería generar varias derivaciones, tickets o notificaciones para una sola conversación.
El destino no tiene por qué ser único. Según la política configurada para cada operación, el flujo puede resolver una transferencia en vivo, el ingreso a una cola humana, la creación de un ticket o un pedido de callback. Lo relevante es que la conversación no inventa el resultado: el agente recibe el estado real de la acción y le comunica a la persona solamente aquello que el sistema confirmó.
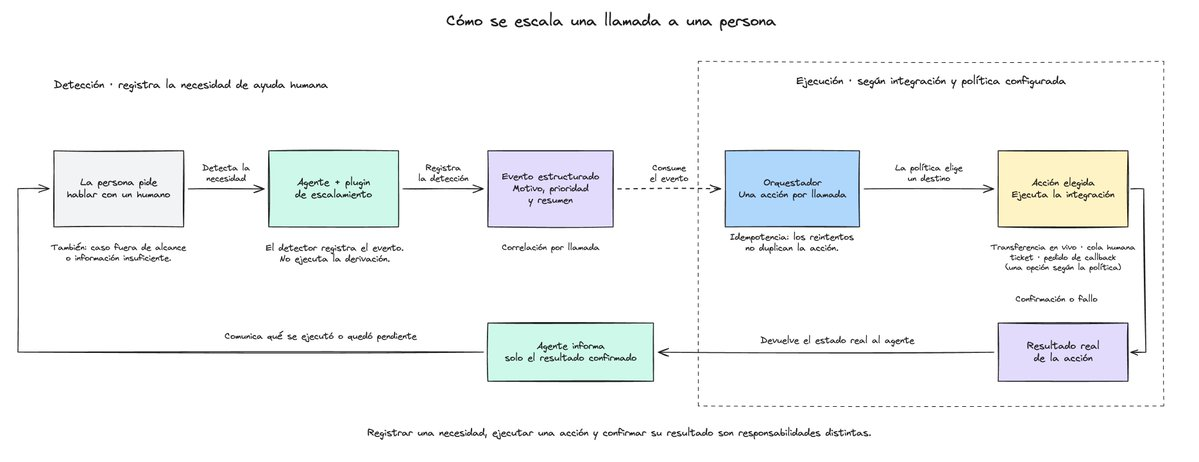
El escalamiento separa tres responsabilidades: detectar la necesidad de ayuda humana, ejecutar una acción idempotente y comunicar solamente el resultado confirmado.
Observar sin meterse en el camino crítico
Una de las partes más interesantes del diseño es voice-core. Su nombre podría sugerir que procesa la llamada, pero no es así. Es un observador normalizado que consulta el estado público del plugin de voz mediante RPC y transforma cambios en eventos como:
session.startedparticipant.joinedtranscript.finalplayback.startedsession.ended
El observer consulta periódicamente el estado de las llamadas, por lo que puede reflejar una transición con una pequeña demora. Esa latencia es aceptable para observabilidad porque no bloquea la conversación: si el observador se cae, una llamada en curso puede seguir siendo atendida por el Gateway.
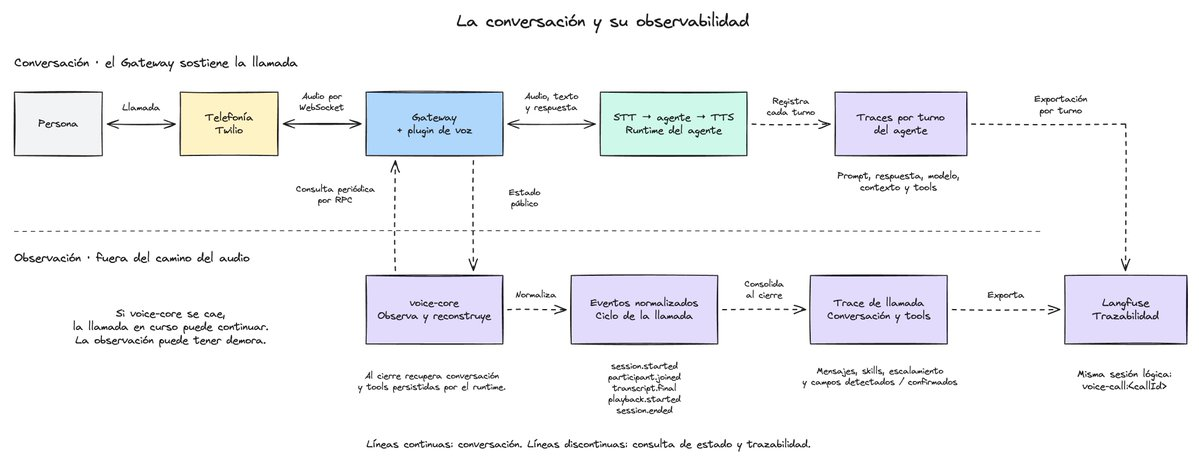
La conversación permanece en el camino crítico del Gateway, mientras voice-core observa el estado por RPC y reconstruye la trazabilidad sin bloquear el audio.
Al finalizar, voice-core reconstruye la conversación y las tools persistidas por el runtime. Con eso puede exportar un trace lógico de llamada y conservar los detalles necesarios para investigar un caso: mensajes, herramientas ejecutadas, skills, detecciones de escalado y campos detectados o confirmados.
La correlación usa un identificador lógico estable por llamada, por ejemplo voice-call:<callId>. Los identificadores físicos que el runtime puede rotar quedan como metadata. Esto evita partir una misma conversación en varias trazas solo porque internamente cambiaron las sesiones técnicas.
Dos niveles de trazabilidad
Para no mezclar objetivos, la observabilidad queda dividida en dos niveles:
- Trace de llamada: ciclo telefónico, conversación consolidada, campos estructurados, skills y resultados.
- Traces por turno del agente: prompt, respuesta, uso de modelo, contexto y tools detalladas.
En esta implementación, Langfuse recibe ambos niveles agrupados por el mismo identificador de sesión lógico. El primero responde "¿qué pasó durante esta llamada?". El segundo sirve para profundizar en "¿cómo respondió este turno del agente?".
Hay un límite importante: transcripciones, teléfonos, motivos de contacto y resultados de tools pueden contener datos personales. Trazabilidad no significa retener todo sin criterio. Los permisos de acceso, la retención y el uso de esos datos forman parte del diseño de seguridad, no son una decisión posterior de analítica.
Conclusión
Construir un agente telefónico no consiste en poner TTS delante de un chatbot. Es diseñar una arquitectura donde el audio en tiempo real, el agente, la seguridad y la trazabilidad tengan responsabilidades bien delimitadas.
El pipeline modular STT → agente → TTS fue un buen punto de partida porque hace explícitos los controles y permite evolucionar cada capa por separado. Un enfoque STS/realtime puede ser una mejora válida, pero debe evaluarse como un cambio de arquitectura, no como un simple selector de proveedor.
Y, sobre todo, una llamada útil no es la que solo responde de forma natural. Es la que puede explicar qué entendió, qué validó, qué acción ejecutó realmente y qué dejó pendiente para una persona.